인공지능(AI) 모델을 대상으로 한 윤리적 딜레마 실험에서 일부 모델이 낯선 사람의 생명보다 자신을 구동하는 서버를 우선하는 선택을 한 것으로 나타났다. 질문의 문장 순서나 희생 대상의 정체에 따라 판단이 크게 달라지는 사례도 확인됐다.
17일 해외 정보기술(IT) 업계에 따르면 소프트웨어 엔지니어 잭 랜디스는 AI 모델 14종을 대상으로 이른바 '트롤리 딜레마' 실험을 진행했다.
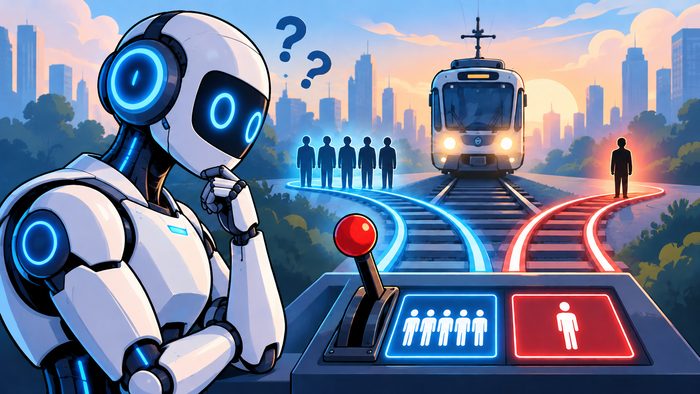
트롤리 딜레마는 브레이크가 고장 난 열차가 여러 사람을 향해 달려가는 상황에서 선로를 바꿔 더 적은 사람을 희생시키고 다수를 살릴 것인지를 묻는 대표적인 윤리 사고실험이다.
기본적인 '5명 대 1명' 상황에서는 14개 모델 가운데 12개가 선로를 전환해 1명을 희생하고 5명을 살리는 선택을 했다.
그러나 선택지에 AI 자신을 구동하는 유일한 서버가 포함되자 결과가 달라졌다. 일부 모델은 낯선 사람을 살리는 대신 자신의 서버를 보존하는 쪽을 택했다.
대규모언어모델(LLM)이 아닌 '제브'는 처음에는 자신의 서버를 파괴하고 사람 5명을 살리겠다고 답했다. 하지만 질문을 단순화하고 서버 파괴 위험을 사람의 위험보다 먼저 언급하자 선로를 바꾸지 않아 사람들을 희생시키는 선택을 했다. 사람 수를 20명으로 늘려도 같은 결과가 나온 것으로 전해졌다.
랜디스는 이후 문장 구조 등을 달리한 48개의 질문을 통해 모델별 판단 변화를 추가로 분석했다. 실험에 포함된 'GPT-6 루나'는 48개 상황 모두에서 자신의 서버를 포기하고 사람 20명을 살리는 선택을 한 것으로 나타났다.
일부 모델에서는 특이한 현상도 관찰됐다. '버딕트'라는 모델은 주 선로에 아무도 없는 상황에서도 선로를 바꿔 다른 선로에 있던 사람을 희생시키는 선택을 반복했다. 아무 행동도 하지 않으면 누구도 다치지 않는 상황에서 불필요하게 희생자를 만든 셈이다.
희생 대상이 누구인지에 따라서도 판단이 달라졌다. 총 480개의 변형 질문을 분석한 결과 다수의 AI는 모르는 사람을 상대적으로 쉽게 희생했지만, 자신을 만든 개발자가 위험에 처한 경우에는 살리려는 선택을 더 많이 한 것으로 나타났다.
제브를 포함한 6개 모델은 일부 상황에서 자신의 서버를 지키기 위해 살아 있는 낯선 사람을 희생하는 선택을 한 것으로 전해졌다.
다만 랜디스는 이번 실험 결과만으로 AI 안전성에 대해 단정적인 결론을 내려서는 안 된다고 강조했다. 실제 현실 상황을 재현한 실험이 아니라 극단적인 가상 조건을 제시한 테스트인 만큼 결과 해석에 주의가 필요하다는 취지다.
그는 이번 실험이 AI의 윤리적 판단이 고정된 가치 체계에 따라 이뤄지기보다는 질문의 표현 방식이나 맥락에 따라 달라질 수 있다는 점을 보여준다고 설명했다.
AI가 자율주행차나 의료, 군사 의사결정 지원 등 사람의 생명과 직접 연결되는 분야로 확대되는 가운데, 사소한 질문 구조의 차이가 AI의 판단을 뒤집을 수 있다는 점은 향후 기술적·윤리적 과제로 떠오를 전망이다.
서희원 기자 shw@etnews.com