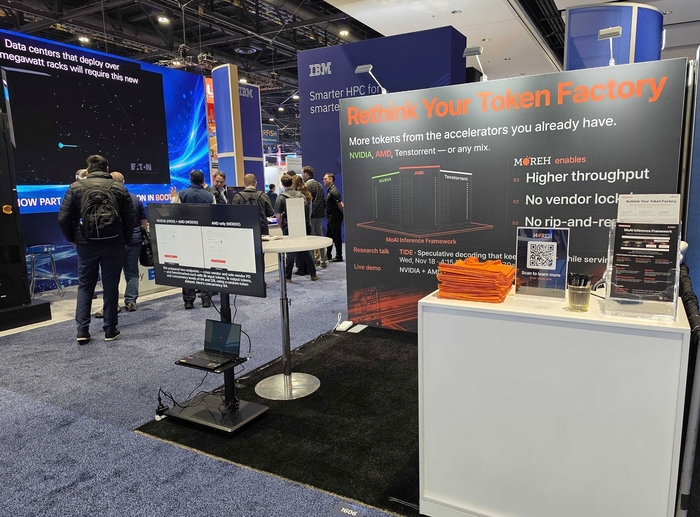
모레는 미국 시카고에서 진행되는 '슈퍼컴퓨팅 2026(SC26)'에서 대규모 언어모델(LLM)의 추론 성능과 효율을 높이는 자기 개선형 추론 프레임워크 'TIDE(Temporal Incremental Draft Engine)'를 첫 공개했다고 20일 밝혔다.
최근 생성형 AI와 추론형 AI의 활용이 확대되면서 대규모 언어모델의 추론 효율은 AI 서비스 경쟁력을 좌우하는 핵심 요소로 부상하고 있다.
모레가 개발한 TIDE는 추론 과정의 비효율을 개선하기 위해 '추측 디코딩' 기술을 활용한다. 추측 디코딩은 상대적으로 작은 보조 모델이 먼저 여러 개의 토큰을 예측하면, 대형 모델이 이를 한꺼번에 검증해 답변 생성 속도를 높이는 방식이다.
기존 방식은 보조 모델이 실제 사용자 요청과 다른 패턴으로 학습돼 있을 경우 예측 정확도가 떨어지고 오히려 추론 성능이 저하될 수 있다는 한계가 있었다.
TIDE는 대형 모델이 실제 추론을 수행하는 과정에서 생성하는 내부 정보인 '중간 은닉 상태'를 재활용해 보조 모델을 점진적으로 학습시킨다. 별도로 대형 모델을 다시 실행해 학습 데이터를 생성할 필요가 없어 추가적인 연산 부담을 줄이면서 실제 서비스 환경에 맞춰 보조 모델의 예측 정확도를 높일 수 있다고 회사는 설명했다.
SC26에서 발표한 연구 결과에 따르면 TIDE는 추측 디코딩을 적용하지 않은 기존 추론 방식 대비 AI 추론 처리량을 최대 1.66배 향상시켰다. 또 대형 모델의 추론 과정에서 생성되는 내부 정보를 별도의 학습 데이터 생성 과정 없이 재활용해 기존 온라인 학습 방식보다 보조 모델의 학습 시간을 최대 3.02배 단축했다.
조강원 모레 대표는 “AI 인프라 경쟁력은 단순히 고성능 GPU를 얼마나 많이 확보하느냐를 넘어 주어진 컴퓨팅 자원을 얼마나 효율적으로 활용해 더 많은 AI 연산을 처리할 수 있느냐에 달려 있다”며 “앞으로도 다양한 GPU 환경에서 AI 추론 성능과 자원 활용 효율을 극대화할 수 있는 소프트웨어 기술을 지속 개발해 나갈 것”이라고 말했다.
모레는 엔비디아·AMD 등 서로 다른 제조사의 GPU를 통합 운영하고 AI 추론 효율을 높이는 인프라 소프트웨어 전문기업이다. 최근에는 이기종 AI 가속기의 연산 자원을 최적으로 배분해 데이터센터의 토큰 생산 효율을 높이는 '토큰 팩토리 OS' 개발에 주력하고 있다.
정현정 기자 iam@etnews.com