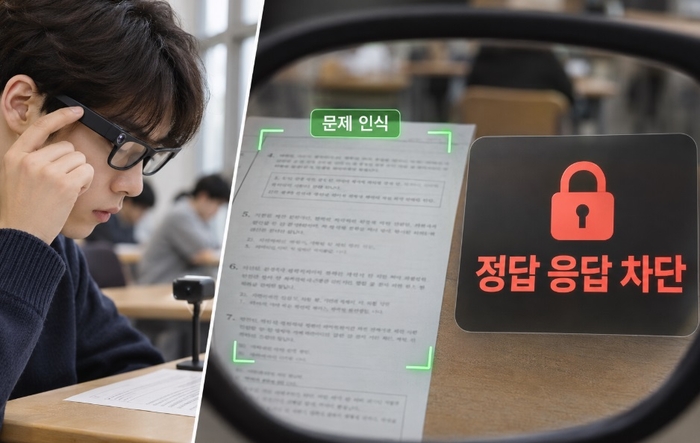
스마트안경과 AI 카메라로 시험 문제를 촬영해 생성형 AI에게 답을 받는 방식이 시험 부정행위의 우려로 떠오르고 있는 가운데, AI 보안 기업 야타브가 시험지 보안 인쇄와 네트워크 기반 AI 응답 통제를 결합한 시험 보안 아키텍처를 개발했다고 밝혔다. AI가 문제를 인식하지 못하게 막는 대신, 문제를 인식하더라도 정답과 풀이를 내놓지 못하도록 정책으로 통제한다는 구상이다.
방식은 두 단계로, 먼저 시험지 상단이나 여백에 AI가 인식할 수 있는 보안 지시문을 넣는다. 이미 제작된 시험지에는 보안 문구가 담긴 도장을 찍고, 신규 시험지에는 인쇄 단계에서 삽입한다. 사람 눈에는 거의 보이지 않는 저대비 인쇄나 특수 잉크, 광학 패턴도 검토 대상이다. 이미지 속 문구로 AI의 동작을 바꾸는 공격 기법인 '비주얼 프롬프트 인젝션'의 원리를 거꾸로 방어에 응용한 것이다.
다음은 네트워크 단계다. 촬영된 시험지 이미지가 AI 서비스로 전송되면 보안 게이트웨이가 시험지의 식별 정보를 탐지하고, 문자인식(OCR)과 시각언어모델(VLM)로 시험 문항인지 판별한다. 시험 문항으로 판단되면 정답 생성 요청을 차단하거나 AI가 만든 응답의 전달을 제한하고, 처리 내역을 감사 로그로 남긴다. 야타브는 자사의 AI 정보유출방지(DLP) 기술과 AI 보안 장비 'AEGIS5000'을 이 통제 계층에 활용하는 방안을 검토하고 있다.
AI 모델 자체를 수정할 필요가 없다는 점이 이 방식의 특징이다. 모델의 학습 구조나 가중치는 그대로 두고 입력과 출력이 오가는 경로에서 정책을 적용하기 때문이다.
야타브 관계자는 “AI가 시험 문제를 얼마나 잘 푸는지 못지않게, 풀어서는 안 되는 상황에서 그 행위를 어떻게 통제할지도 중요한 연구 과제가 됐다“며 “모든 스마트안경과 카메라를 탐지하지 않더라도 AI의 입력과 출력 경로를 관리할 수 있다면 그 경로에서 부정행위를 제한하는 것이 가능해진다”고 말했다.
이원지 기자 news21g@etnews.com