샌즈랩이 생성형 인공지능(AI)으로 변형한 악성코드에서도 원본과의 연관성을 파악할 수 있는 단서를 발견했다. AI가 악성코드의 구조와 작성 방식을 바꾸더라도 일정한 특징이 남는다는 사실을 실험으로 확인한 것이다.
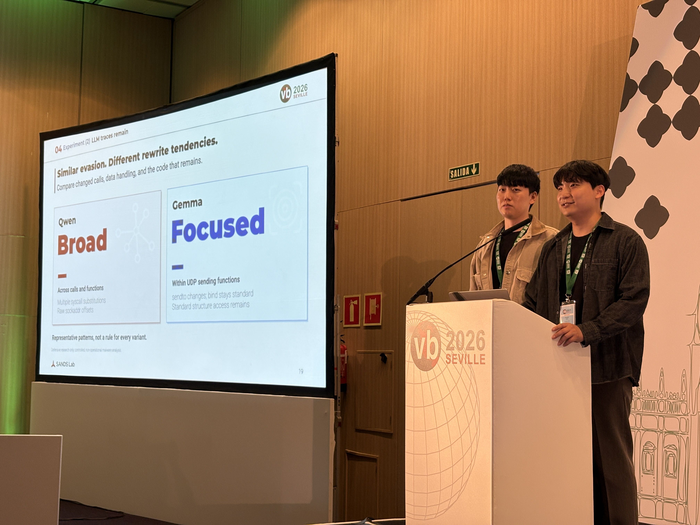
샌즈랩은 14일(현지시간) 스페인 세비야에서 열린 국제 보안 콘퍼런스 '바이러스블러틴 2026(VB2026)'에서 관련 연구 성과를 발표했다.
이번 연구는 생성형 AI가 악성코드의 기능은 유지하면서 내부 코드와 구조를 바꿀 경우 기존 분석 방식으로는 원본과 변종 간 연관성을 파악하기 어려워진다는 문제에서 출발했다.
샌즈랩 연구팀은 자체 개발한 연구용 프레임워크 '고스트(GHOST)'를 활용해 5개 악성코드 계열과 2종의 대규모언어모델(LLM)을 대상으로 총 50차례 실험을 진행했다. GHOST는 LLM을 이용해 악성코드의 구조와 코드 표현을 자동으로 변형하는 도구다.
실험 결과 정상적으로 작동하는 악성코드 변종을 생성하는 데 95%의 성공률을 기록했으며, 한 차례 실험에서는 악성 행위 탐지 규칙 46개 중 22개를 우회했다.
연구팀은 변형된 실행파일을 함수 단위로 비교·분석해 코드가 달라져도 함수 구조와 데이터 처리 방식에 AI 모델별로 반복되는 특징이 남는다는 사실을 확인했다.
AI 모델별 구조적 특징은 실행파일로 컴파일된 이후에도 유지됐으며, 연구팀은 이를 함수 단위 코드 임베딩으로 분석해 서로 다른 악성코드 사이의 연관성을 파악하는 방법을 제시했다.
샌즈랩은 이러한 분석 방법을 활용하면 AI로 대량 생성된 악성코드 변종 가운데 연관성이 있는 샘플을 식별하고, 추가 분석이 필요한 함수와 코드를 좁힐 수 있을 것으로 보고 있다.
샌즈랩은 지난해 VB에서 LLM을 활용한 악성코드 계보 추적 연구를 발표한 데 이어 올해는 AI 모델별 코드 변형 특징까지 분석 범위를 확대했다.
전찬빈 샌즈랩 선임연구원은 “해외 전문가들에게 연구 중인 기술을 직접 선보이고 질문과 피드백을 받는 것은 기술의 실효성과 한계를 점검하는 중요한 과정”이라며 “실제 위협 분석 현장에 필요한 기술을 검증하고 발전시켜 나가겠다”고 말했다.
박진형 기자 jin@etnews.com