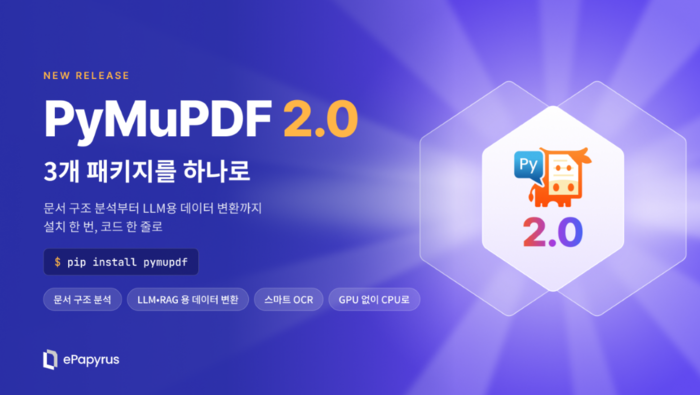
문서 인공지능(AI) 전문기업 이파피루스(대표 김정희)는 글로벌 다운로드 누적 12억 건을 돌파한 오픈소스 문서 처리 라이브러리 PyMuPDF를 2.0 버전으로 업데이트했다고 27일 밝혔다.
이번 업데이트의 통합이다. 그동안 별도 패키지로 제공되던 대규모 언어모델(LLM)용 데이터 변환 도구 PyMuPDF4LLM과 레이아웃 분석 엔진 PyMuPDF Layout을 PyMuPDF 하나로 합쳤다.
기존에는 개발자가 세 패키지 가운데 필요한 기능을 골라 조합해 쓸 수 있었다. 2.0에서는 함께 발전해 온 세 패키지를 하나로 묶어 사용 편의성을 한층 높였다고 회사측은 설명했다.
명령어 한 줄이면 패키지별 버전 관리나 설치 순서를 신경 쓸 필요 없이 제품군 전체의 기능을 바로 활용할 수 있다. 기존 import pymupdf4llm 등의 방식도 그대로 지원해, 기존 사용자는 코드를 수정하지 않아도 된다.
통합된 PyMuPDF는 문서 구조 분석부터 LLM용 데이터 변환까지 하나의 흐름으로 처리한다.
먼저 그래프 신경망(GNN) 기반 레이아웃 분석이 기본으로 적용돼, 다단 문서나 각주가 섞인 문서도 사람이 읽는 순서(Reading Order) 그대로 구조와 표(Table)의 의미를 파악한다.
광학문자인식(OCR)이 필요한 부분은 해당 영역에만 OCR을 적용하는 스마트 OCR로 처리하며, 추출 결과는 마크다운(Markdown)·JSON 등 LLM에 최적화된 포맷으로 바로 변환된다.
이 모든 과정은 GPU 없이 CPU만으로 동작한다. 페이지를 이미지로 변환해 분석하는 GPU 기반 파서나 시각언어모델(VLM) 대비 약 100분의 1 수준의 하드웨어 자원으로 최고 10배이상 빠르게 처리한다. 클라우드를 거치지 않아 온프레미스·폐쇄망 환경에서도 문서 외부 유출 우려 없이 활용할 수 있다.
이러한 기술력은 외부 평가와 도입 사례로도 입증됐다고 했다. PyMuPDF는 라마인덱스(LlamaIndex)가 주관하는 AI 문서 파싱 벤치마크 'ParseBench'에서 표 구조 파악, 본문 정확도 등 핵심 지표 전반에 걸쳐 IBM Doclin 대비 우수한 결과를 기록한 바 있다고 회사측은 전했다.
김정아 이파피루스 부사장은 “PyMuPDF는 전 세계 개발자들의 꾸준한 선택을 받으며 누적 다운로드 12억 건을 넘어선 문서 처리 분야의 대표 라이브러리로 자리 잡았다”면서 “이번 2.0 업데이트를 발판으로 기술력과 사용 편의성을 한층 강화하고 글로벌 비즈니스 성장에도 더욱 속도를 내, 명실상부한 글로벌 매출 1위 문서 처리 솔루션으로 성장해 나가겠다”고 밝혔다.
이경민 기자 kmlee@etnews.com