


문서 읽기 순서 반영해 마크다운·JSON으로 데이터 추출
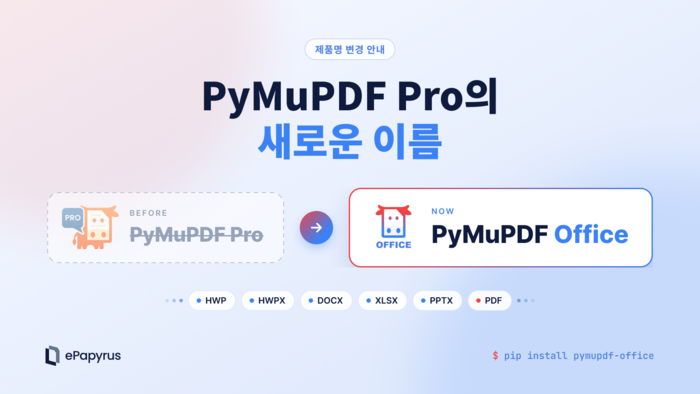
이파피루스(대표 김정희)는 문서 데이터 추출 엔진 '파이뮤PDF 프로(PyMuPDF Pro)'의 제품명을 '파이뮤PDF 오피스(PyMuPDF Office)'로 변경했다고 2일 밝혔다.
이번 변경은 아래한글(HWP/HWPX)과 마이크로소프트(MS) 오피스 문서 처리라는 제품의 역할을 명확히 하기 위한 것이다. PDF를 넘어 기업과 공공기관이 보유한 다양한 업무 문서를 인공지능(AI) 활용 데이터로 전환한다는 의미를 새 이름에 담았다.
파이뮤PDF 오피스는 오픈소스 문서 데이터 추출 라이브러리 '파이뮤PDF(PyMuPDF)'에 아래한글과 워드·엑셀·파워포인트 문서 처리 기능을 더한 상용 제품이다. 기반 오픈소스는 글로벌 누적 다운로드 12억건을 넘어섰다.
최근 파이뮤PDF가 2.0 버전에서 대규모 언어모델(LLM)용 데이터 변환 도구 '파이뮤PDF4LLM(PyMuPDF4LLM)'과 레이아웃 분석 엔진 '파이뮤PDF 레이아웃(PyMuPDF Layout)'을 기본 패키지에 통합하면서 제품 간 구분도 필요해졌다. PDF 처리는 오픈소스가 담당하고 한글·MS 오피스 문서까지 처리하려는 고객은 상용 제품을 활용하는 구조다.
핵심 기능은 문서의 구성과 읽기 순서를 반영한 데이터 추출이다. 텍스트와 이미지, 표, 목록을 사람이 읽는 순서에 맞춰 분석하고 마크다운과 제이슨(JSON) 등 LLM 활용에 적합한 형식으로 변환한다. 한글 문서를 다른 형식으로 먼저 변환하는 과정 없이 AI 학습과 검색증강생성(RAG)에 필요한 데이터를 만들 수 있다는 게 회사 설명이다.
도입 방식도 차별점으로 내세웠다. 별도 오피스 프로그램을 설치하거나 전용 서버를 구축할 필요 없이 경량 파이썬 패키지를 기존 코드에 적용해 사용할 수 있다. 그래픽처리장치(GPU) 없이 중앙처리장치(CPU)만으로 문서를 처리해 기존 인프라를 활용할 수 있다.
문서를 외부 클라우드로 전송하지 않고 내부 서버나 사내 PC에서 처리하는 것도 특징이다. 이파피루스는 한글 문서 활용도가 높고 폐쇄망 운영이 많은 공공기관의 AI 전환 수요에 대응할 수 있을 것으로 기대하고 있다.
기존 고객은 발급받은 라이선스 키를 새 패키지 파이뮤PDF 오피스에서도 그대로 사용할 수 있다. 기존 패키지도 계속 이용할 수 있으며, 배포 종료 일정과 전환 방법은 추후 개별 안내할 예정이다.
김정아 이파피루스 부사장은 “기업이 AI에 활용하려는 데이터는 PDF만큼이나 아래한글과 MS 오피스 문서에 많이 담겨 있다”며 “파이뮤PDF 오피스라는 이름에는 이런 업무 문서를 가장 잘 다루는 제품이 되겠다는 의지를 담았다”고 말했다.
권상희 기자 shkwon@etnews.com

