AI 반도체 시장 무게중심이 학습에서 추론으로 이동한다. 생성형 인공지능(AI)과 에이전틱 AI 서비스가 확산하면서다. 가속기 경쟁력도 단순 연산 성능을 넘어 메모리, 전력, 네트워크, 운영비용을 종합적으로 최적화하는 방향으로 변화한다.
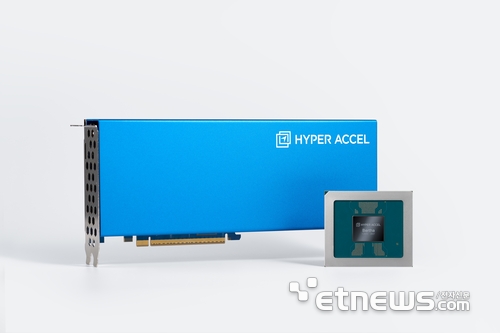
국내 AI 반도체 스타트업 하이퍼엑셀은 거대언어모델(LLM) 추론에 특화된 LPU(LLM Processing Unit)를 앞세워 이 시장을 공략하고 있다. GPU를 대체하기보다는 워크로드에 따라 다양한 가속기를 조합하는 AI 인프라의 한 축을 지향한다.
GPU가 높은 범용성과 대규모 병렬 연산 능력을 바탕으로 학습과 추론 등 다양한 작업에 활용된다면, LPU는 언어모델 추론에 필요한 연산과 데이터 처리 구조를 효율화하는 데 중점을 둔다.
하이퍼엑셀의 핵심은 '인퍼런스 퍼스트 아키텍처'다. 최대 연산 성능보다 실제 추론 과정에서 메모리와 연산장치 사이의 데이터 이동을 효율화하고, 토큰 처리량과 총소유비용(TCO)을 함께 고려하는 설계다.
LLM 추론에서는 모델 가중치와 이전 대화 정보를 메모리에서 반복적으로 읽어야 한다. 하이퍼엑셀은 데이터 흐름을 단순화한 '스트림라인드 데이터플로' 구조를 적용했다. 일반 GPU의 메모리 대역폭 활용률이 50~60% 수준인 데 비해 LPU는 약 90%를 활용하도록 설계됐다.
메모리에는 LPDDR5X를 채택했다. HBM보다 절대 대역폭은 낮지만 대용량 메모리 구성과 전력·비용 측면의 이점을 활용해 추론에 적합한 균형을 확보한다는 전략이다.
주요 제품군은 데이터센터 AI추론 가속기 '베르타 500'이다. 삼성전자 4나노미터 공정을 기반으로 192GB 저전력 D램(LPDDR5X) 메모리와 초당 546GB 대역폭을 제공한다. 열설계전력은 250W다.
알리바바 LLM '큐웬3-235B' 모델과 비교하면 특정 추론 조건에서 H100 대비 전력당 효율 최대 5.7배, 비용당 효율 최대 6.2배를 달성했다는 게 회사 측 설명이다.
하이퍼엑셀은 개발자들이 기존 AI 모델을 LPU에서도 쉽게 활용할 수 있도록 소프트웨어를 지원하고 있다. 기존 GPU 인프라와 LPU를 함께 활용해 작업별로 적합한 가속기를 배치함으로써 AI 서비스 운영비용을 낮추고 인프라 선택지를 넓히겠다는 구상이다.
제품군도 확대하고 있다. 소비전력이 15W 미만인 '베르타-엣지'를 개발해 로봇과 스마트기기 등 기기 자체에서 AI를 실행하는 엣지 AI 시장으로 사업 영역을 넓히고 있다.
박유민 기자 newmin@etnews.com