엔비디아가 차세대 인공지능(AI) 가속기 플랫폼 '베라 루빈(Vera Rubin)'에 탑재할 6세대 고대역폭메모리(HBM4)의 대역폭(속도) 목표치를 하향 조정했다. 무리한 최고 사양 고집으로 공급 병목을 자초하기보다, 눈높이를 현실화해 안정적인 초도 물량과 수율을 확보하겠다는 전략적 판단으로 풀이된다.
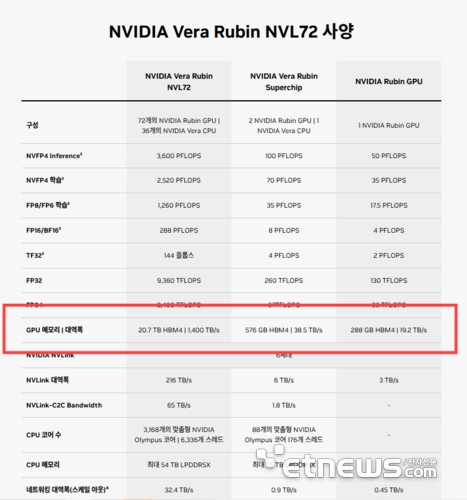
27일 업계에 따르면 엔비디아는 최근 공식 홈페이지 내 베라 루빈 스펙 데이터시트의 GPU당 HBM4 메모리 대역폭을 기존 초당 22테라바이트(TB/s)에서 19.2TB/s로 약 13% 낮춰 기재했다.
랙 단위 시스템인 'NVL72' 기준 전체 대역폭 역시 1580TB/s에서 1400TB/s로 조정됐다. HBM4 용량(288GB)과 NVFP4 연산 성능 등 핵심 코어 스펙은 기존 수치를 유지했다. 엔비디아는 별도 발표 없이 제품 웹페이지 제원을 수정하는 방식으로 사양을 변경했다.
조정의 핵심은 메모리 '핀 속도' 완화다. 데이터 입출력(I/O) 통로가 2048개에 달하는 HBM4에서 기존 22TB/s 대역폭을 구현하려면 핀당 약 11.7Gbps 수준의 초고속 동작이 뒷받침돼야 한다.
변경된 19.2TB/s는 핀당 9.4~9.6Gbps 수준으로, 입출력 통로(차선 수)는 그대로 둔 채 데이터 전송 제한 속도만 낮춘 셈이다. 조정된 수치라도 전작 블랙웰에 탑재된 HBM3E(약 8TB/s)와 비교하면 여전히 2배를 훌쩍 뛰어넘는 성능이다.
반도체 업계는 이를 '양산 현실성'을 감안한 결정으로 해석했다. HBM4부터는 베이스 다이에 파운드리 로직 공정이 처음 도입되는 등 기술 난도가 급격히 높아져, 최고 속도(하이빈·High-bin) 제품만 고집할 경우 수율 확보가 쉽지 않다. 상대적으로 구현이 수월한 안정적 속도(로빈·Low-bin)를 표준 사양으로 삼아 공급망 저변을 넓히려는 의도로 보인다.
당장 삼성전자, SK하이닉스, 마이크론 등 메모리 3사 모두에게 공정 부담 완화라는 긍정적 효과가 기대된다. 요구 속도 허들이 낮아지면서 양산 수율이 개선되고, 엔비디아 품질 인증(퀄테스트)을 통과할 수 있는 유효 물량 자체가 늘어나기 때문이다. 폭발하는 AI 가속기 수요 속에서 SK하이닉스와 삼성전자의 공급 물량 확대에 속도가 붙을 전망이다.
다만 공급사별 셈법은 복잡해졌다. 고속 동작 구현 능력에서 앞서 있던 선두 업체 입장에서는 후발 주자와의 '기술 프리미엄 격차'가 일부 희석될 수 있다. 반면 초기 HBM4 공급망 진입에 난항을 겪는 것으로 알려진 마이크론은 완화된 기준 덕분에 추격의 발판 마련을 기대할 수 있다.
업계 관계자는 “엔비디아의 사양 조정은 보여주기식 마케팅 수치보다 실제 양산 물량 확보와 시스템 안정성을 최우선에 둔 현실적 타협”이라며 “메모리 병목 현상을 해소하고 멀티 벤더 체제를 공고히 하려는 엔비디아 행보에 맞춰 HBM4 시장의 초기 점유율 경쟁도 새로운 국면을 맞을 것”이라고 진단했다.
이형두 기자 dudu@etnews.com