에이전트형 인공지능(AI)은 질문 한 번에 답을 내는 챗봇과 다르다. 목표를 이해하고 도구를 쓰며 같은 작업을 반복하기 때문에 연산량, 즉 토큰이 급증한다. 단순 대화가 토큰 1이라면 추론형 거대언어모델은 약 10배, 에이전트 시스템은 약 1000배에 이른다. 그래픽처리장치(GPU)를 추가하는 방식으로는 비용과 효율을 맞추기 어렵다. 2022년 설립된 망고부스트는 소프트웨어와 서버, 데이터센터를 한 세트로 묶어 이 문제를 푸는 쪽을 택했다.
김장우 망고부스트 대표(서울대 교수)는 에이전트 인프라 조건으로 세 가지를 제시한다. 여러 모델과 동적 작업을 지휘하는 에이전트 운영체제(OS), 한 종류 GPU에 모든 일을 맡기지 않는 이종 연산, 고대역폭메모리(HBM)에만 의존하지 않는 계층형 메모리다.
무거운 답 생성은 고성능 GPU가, 입력을 먼저 읽는 단계는 보급형 GPU가, 가벼운 추론은 신경망처리장치(NPU)가, 도구 실행은 중앙처리장치(CPU)가 맡는다. 당장 쓰는 맥락은 HBM, 짧은 기억은 일반 메모리, 오래 남길 내용은 저장장치로 나눈다.
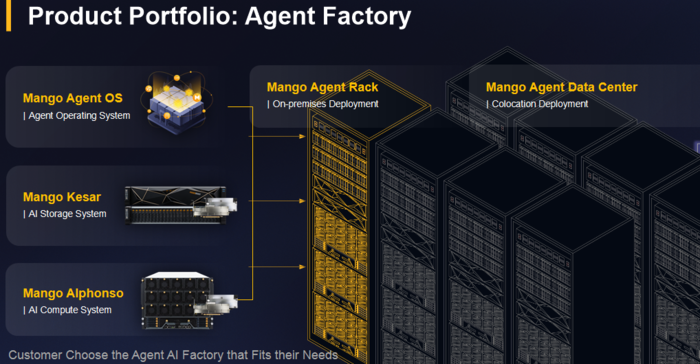
제품군도 이 구조에 맞춰 구성했다. 에이전트 OS가 작업을 배분하고 연산 시스템 '알폰소'와 스토리지 시스템 '케사르'가 계산과 데이터를 처리한다. 기존 서버에 올리는 방식부터 온프레미스 랙, 콜로케이션, 응용프로그래밍인터페이스(API) 서비스까지 규모별로 선택할 수 있다. 코딩·비서형 에이전트는 노드 단위로, 바이오·법률·금융 등 영역별 다중 에이전트는 랙 단위로 공급하는 식이다. 회사는 이 구성을 '에이전트 팩토리'로 부른다.
성능은 공개 벤치마크로 제시했다. 코딩 에이전트 작업에서 토큰당 응답 시간(TPOT)을 96밀리초에서 57밀리초로 약 40% 줄였다. 같은 작업을 반복하는 에이전트일수록 이 차이가 커진다.
한 종류의 고성능 그래픽카드에만 의존하지 않아도 되는지를 보는 시험이 국제 벤치마크 ML퍼프다. 추론 5.0에서는 같은 비용을 쓸 때 처리량이 약 3배로 집계됐고, 추론 6.0에서는 미국 델 연구소의 AMD 인스팅트 MI355X와 한국에 둔 MI300X·MI325X를 한 작업으로 묶어, 기종이 다르고 설치 장소가 달라도 추론이 이어진다는 점을 확인했다.
연산만 빨라져서는 부족하다. 데이터가 따라오지 못하면 칩이 다시 논다. 저장 구간을 자사 방식으로 구성하면 5년간 구축·운영 총비용을 74.4% 낮출 수 있다는 자체 분석도 내놓았다. 장비를 사는 비용은 72.7%, 운영 비용은 82.4% 줄어드는 것으로 나왔다.
네트워크는 특정 기업 전용 규격 대신 이더넷을 채택했다. 여러 회사 GPU와 NPU, 기존 세대와 새 세대를 한 인프라에서 운용해 장비 수명을 늘리는 것이 핵심이다.
망고부스트는 엔지니어 120여 명과 특허 50건 이상, 누적 투자 1억 달러 이상을 확보했다. 글로벌 투자사는 20곳이 넘고, 연구개발(R&D) 기간은 이미 10년 이상이다. 본사는 미국 벨뷰에 있으며 서울과 샌호세, 도쿄 등에도 거점을 두고 있다.
이형두 기자 dudu@etnews.com